Архивные медиаданные: как оцифровка меняет работу редакций
В редакционных подвалах российских телекомпаний и газет до сих пор лежат тысячи часов видеозаписей на плёнке и кипы подшивок, которые никто не перелистывал годами.
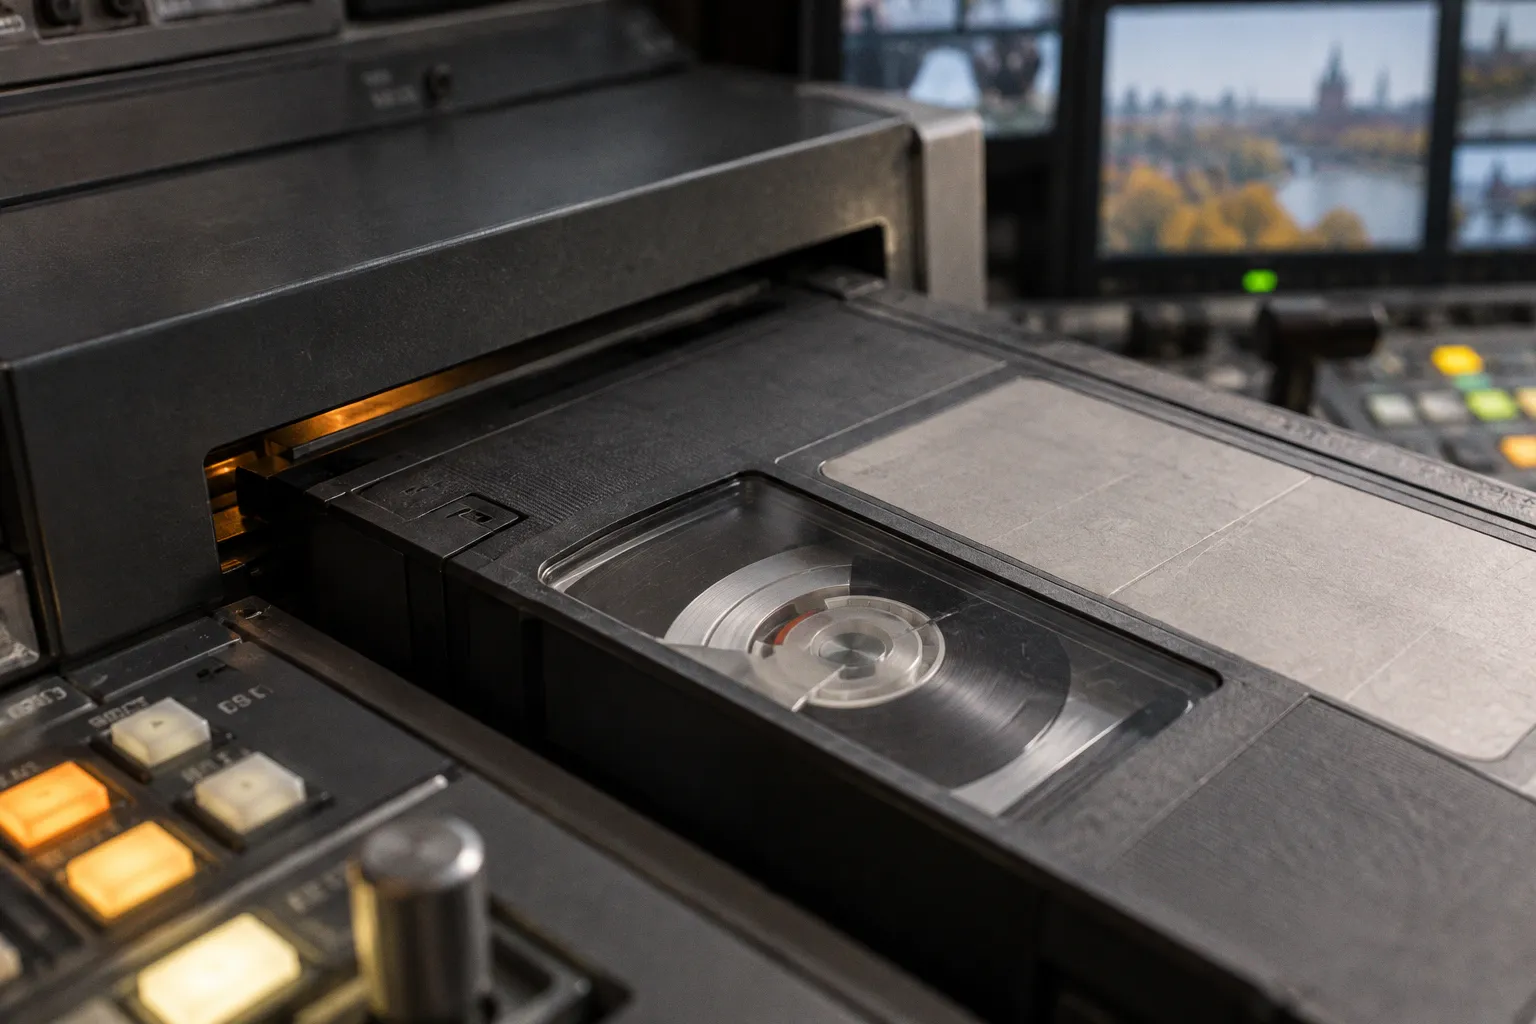
Они стареют, рассыпаются и теряют первоисточники — иногда тихо, иногда вместе с архивом сгорает часть профессиональной памяти. В 2024 году телеканал РЕН ТВ взялся за собственный видеофонд: более семи тысяч видеокассет семейства Betacam, свыше десяти тысяч часов записи и девять месяцев на перевод в цифру. Это большой проект с понятными сроками и масштабом — и хороший повод разобраться, что происходит с редакционным наследием в эпоху, когда журналистика перестраивается под алгоритмы и платформы.
Масштабы и вызовы оцифровки: опыт крупных медиахолдингов
Задача, которую ставят перед собой федеральные вещатели, газетные холдинги и информагентства, давно вышла за пределы «просто переписать на диск». Аналоговый архив — многослойная инфраструктурная проблема: физический износ носителей, разнородность форматов, отсутствие единой каталогизации и зависимость от конкретного инженера, который помнит, где лежит та самая плёнка про Гагарина. При попытке оцифровать даже относительно компактный фонд — несколько тысяч единиц хранения — редакции быстро упираются в три взаимосвязанных дефицита: оборудование для воспроизведения устаревших форматов, квалифицированные кадры, способные работать с дефектными носителями, и ресурсы для последующей обработки и каталогизации материалов.
В случае РЕН ТВ известны масштаб фонда и срок, отведённый на проект. Этих данных достаточно, чтобы увидеть сложность задачи, но недостаточно, чтобы судить о конкретной технологической схеме работ или объяснять, за счёт чего удалось выдержать график. Здесь важна и простая арифметика: свыше десяти тысяч часов — это более четырёхсот дней непрерывного просмотра, то есть примерно год и два месяца, если считать нижнюю границу и не останавливаться ни на минуту. Для редакционной работы это не прямой расчёт срока оцифровки: перенос материала, проверка качества и последующая каталогизация — отдельные процессы, а сам архив не обязательно нужно просматривать целиком в реальном времени.
Масштаб здесь не самоцель. Каждая единица хранения может оказаться сюжетом, репортажем, документом эпохи, который редакция поднимет к годовщине, использует в расследовании или включит в архивный спецвыпуск. Когда носитель выходит из строя, теряется не просто картинка — могут исчезнуть авторская интонация, монтажная логика, технологический почерк редакции и времени. Оцифровка в этом смысле — акт журналистской самозащиты: либо редакция успевает перевести наследие в управляемый формат, либо её собственный фундамент продолжает стареть вместе с лентой.
При этом перевести носитель в цифровой файл — ещё не значит спасти архив. Файл без описания легко становится такой же недоступной единицей хранения, как кассета в коробке с выцветшей наклейкой. Поэтому задача проекта не заканчивается захватом изображения и звука: нужно определить, что именно переносится, как материал будет описан и кто сможет найти его спустя годы. Чем больше фонд, тем дороже обходится надежда на память отдельных сотрудников.
Архитектура современных систем управления медиаактивами
Просто сохранить файлы на сервере — половина задачи, и, как правило, не самая трудная. Настоящая проблема возникает, когда редактору нужно найти конкретный фрагмент среди десятков тысяч часов: например, синхрон первого космонавта, съёмку конкретного региона в 2003 году или интервью с ушедшим политиком. Ответом индустрии стали системы управления медиаактивами — MAM (Media Asset Management), которые связывают производственные участки редакции и превращают разрозненный контент в управляемую базу с поиском, правами и метаданными.
Современная MAM — не «файловое хранилище с поиском по имени», а связующее звено между студией, монтажом, эфиром, юридическим отделом и архивом. Система может учитывать видео, аудио, изображения, текстовые материалы и сведения о них: теги персон, даты, локации, права на показ, статус использования. Для тяжёлого исходника часто создают proxy-копию — облегчённую версию, пригодную для быстрого предпросмотра и некоторых монтажных операций без постоянной работы с полноразмерным файлом. Такой подход помогает просматривать материалы через редакционный интерфейс, не загружая каждый раз исходник целиком.
| Атрибут работы с архивом | Аналоговое хранение | Цифровой архив с MAM |
|---|---|---|
| Доступ к материалу | Нужно найти носитель и оборудование для воспроизведения | Можно искать материал через систему и просматривать доступную копию |
| Поиск по содержанию | По этикетке, описи и памяти сотрудника | По заполненным метаданным; при наличии распознавания — также по речи и тексту в кадре |
| Подготовка к эфиру | Материал нужно отдельно перенести на подходящий носитель | Можно работать с цифровой копией, соблюдая установленный порядок выдачи исходников |
| Контроль прав | Отметки на коробке и записи в журнале | Сведения о правах можно связать с карточкой материала и сделать доступными пользователям |
| Риск утраты | Износ, повреждение или потеря физического носителя | Ошибки хранения и доступа; риск снижают резервирование и контроль целостности |
Таблица показывает не автоматическую победу цифрового архива, а изменение типа работы. У MAM тоже есть уязвимости: плохо заполненные метаданные затрудняют поиск, а отсутствие резервных копий не становится менее опасным оттого, что архив размещён на сервере. Но система позволяет связать материал с описанием, правами и производственными задачами — если редакция заранее определила, что именно она будет учитывать.
Критически важно, что MAM — это не столько про хранение, сколько про интерфейс между архивом и повседневной работой редакции. Когда у журналиста в монтажной среде появляется поиск по архиву, тот перестаёт быть подвалом и становится частью редакционного процесса. Разница между «лежит и ждёт» и «используется» определяет, будет ли оцифровка полезна не только архивисту, но и всей редакции.
Преодоление барьеров OCR: работа со сложной вёрсткой и ветхими носителями
Телевизионный архив — лишь часть наследия. Газеты, журналы, информационные агентства десятилетиями копили бумажные подшивки, которые сегодня рассыпаются от одного неосторожного прикосновения. Здесь инструментом спасения становится технология оптического распознавания символов (OCR), но на старых газетах она спотыкается о специфику материала.
Стандартное решение рассчитано на офисный документ: чёткий шрифт, ровную вёрстку, хороший контраст с фоном. Историческая газета — противоположный случай. Многоколоночная вёрстка, заметки, разорванные между полосами, разные по начертанию шрифты, выцветшие чернила, пятна и заломы бумаги, иногда физически утраченные фрагменты. При попытке распознать такую страницу обычный движок может выдать сплошной поток символов без деления на статьи: колонки сливаются, заголовки смешиваются с подписями к фотографиям, реклама оказывается в одном абзаце с передовицей. Такой файл формально проиндексирован, но редактору всё ещё трудно ориентироваться в нём как в газете.
Решение — обработка изображения и сегментация страницы до распознавания текста. Специализированные инструменты могут разделять полосу на области, определять колонки и помогать установить порядок чтения. Но результат зависит от состояния оригинала, качества скана и особенностей конкретной вёрстки: полностью автоматическая обработка не гарантирует, что каждый заголовок и каждый фрагмент будут распознаны верно. После сегментации OCR применяют к отдельным областям — статьям или заметкам, — а полученный текст проверяют и связывают с изображением страницы.
Для печатных СМИ это принципиально. Двухслойный PDF, где изображение страницы соседствует с текстовым OCR-слоем, позволяет сохранять визуальный оригинал и одновременно искать по распознанному тексту. Исследователь, журналист или редактор видит исходную полосу, а система получает текст, который можно индексировать. Если же система дополнительно хранит сведения о рубрике, авторе и заголовке, найденный фрагмент легче вернуть в контекст номера.
Главный вызов не только в том, чтобы распознать букву, но и в том, чтобы понять, где заканчивается одна заметка и начинается соседняя. Без сегментации OCR может выдать текст, в котором трудно ориентироваться.
Здесь снова работает общий для оцифровки принцип: качество зависит не от вычислительной мощности как таковой, а от того, насколько процесс учитывает природу источника. Газету нельзя обрабатывать как офисный скан, телевизионный архив — как видео с телефона. Чем точнее настроены захват и последующая обработка под конкретный тип носителя, тем больше шансов, что цифровая копия станет рабочим архивом, а не формальным дублем.
У ветхих материалов есть и физическая сторона. Иногда прежде, чем сканировать или проигрывать носитель, нужно оценить его состояние и подобрать способ обращения. Поспешность здесь может обернуться повреждением оригинала; слишком осторожный подход — затянуть оцифровку до момента, когда материал станет нечитаемым. Поэтому сохранение первоисточника и создание цифровой копии должны быть связаны, но не подменять друг друга: техника обработки не исправит утраченный фрагмент, а цифровой файл не вернёт информацию, которой уже нет на носителе.
ИИ-интеграция: автоматическая разметка и поиск с точностью до миллисекунд
Если MAM — скелет архива, то инструменты искусственного интеллекта могут стать его нервной системой: они помогают описывать, что находится в кадре и на записи, без ручной обработки каждого материала целиком. MAM-системы могут подключаться к отдельным сервисам распознавания речи, текста в кадре и изображений. Распознавание речи превращает интервью или закадровый текст в расшифровку, иногда с временными метками. OCR извлекает надписи с плакатов, вывесок, титров и эфирной графики. Поиск по лицам и визуальным признакам может помочь находить похожие кадры или предполагаемые появления человека, но его результаты требуют проверки.
Уровень детализации временных меток зависит от инструмента, качества записи и настроек. В некоторых системах можно искать фрагмент с привязкой к моменту внутри записи, но превращать «точность до миллисекунд» в универсальную характеристику ИИ-разметки было бы неверно. Для редактора важнее другое: система должна показать, откуда взялся найденный фрагмент и насколько надёжно его описание.
Автоматическая расшифровка меняет характер работы с архивом. Вместо того чтобы просматривать длинную запись от начала до конца, редактор может искать по тексту и переходить к подходящим моментам. Например, запросить интервью с конкретным политиком, где обсуждается определённая тема, затем сверить найденные реплики с видео и составить монтажный план. Это не отменяет просмотра и проверки: поисковая выдача помогает сузить поле, но не решает, какой именно фрагмент уместен в новом материале.
Именно здесь возникает профессиональный вопрос: где проходит граница между машинной разметкой и редакционной ответственностью. Распознавание лиц может предложить совпадение, но само по себе не устанавливает, кто именно находится в кадре и в каком контексте. OCR способен распознать надпись, но не всегда различает прямую цитату, иронию и случайный фон. Полагаться на автоматические теги без проверки рискованно: в архиве могут появиться перепутанные спикеры, ошибки расшифровки и описания, которые вырывают фрагмент из контекста.
Машина может подсказать, где в архиве искать ответ. Проверить, действительно ли найденный фрагмент отвечает на нужный вопрос, — работа редактора.
Поэтому автоматическую разметку разумно рассматривать как черновой слой метаданных. Редакция определяет, какие поля проверять обязательно, а какие можно уточнять по мере использования. Для материала, который готовят к эфиру или публикации, нужна проверка исходника и контекста; для первичного поиска может быть достаточно подсказки системы. Такой подход не избавляет от редакционной работы, но помогает направить её туда, где ошибка действительно меняет смысл.
ИИ здесь — не замена редактора, а ускоритель и справочник. Его польза зависит от того, насколько ясно обозначено, что система распознала автоматически, а что подтвердил человек. Если эти уровни смешаны, уверенно выглядящий тег может восприниматься как проверенный факт — и переносить ошибку из старого материала в новый.
Баланс между цифровым доступом и физическим хранением первоисточников
Вопрос о том, нужно ли хранить оригинал, если цифровая копия уже создана, не имеет универсального ответа. Здесь пересекаются экономика, юридическая логика и редакционная этика. Решение зависит от типа носителя, состояния оригинала, его исторической ценности и того, какие обязательства редакция несёт перед владельцами прав и аудиторией.
Аргументы в пользу сокращения физических архивов понятны: помещения стоят денег, за условиями хранения нужно следить, фонды — учитывать, а устаревшее оборудование — обслуживать. Цифровая копия упрощает доступ и позволяет создавать резервные экземпляры. Но сам факт оцифровки не означает, что файл автоматически защищён от утраты: нужны правила хранения, резервирования, проверки целостности и переноса на новые системы, когда прежние устаревают.
У оригинала при этом остаётся своя ценность. Он может быть важен для повторной проверки, исторического исследования или разбирательства о происхождении материала. Цифровой файл — результат переноса с носителя и последующей обработки; в зависимости от процесса могли измениться формат, цвет, звук или иные свойства записи. Поэтому при споре о подлинности возможность обратиться к первоисточнику может иметь значение. Для газетной подшивки это ещё и физическое свидетельство конкретного выпуска; для плёнки — носитель, по которому можно сверить происхождение и содержание записи.
Практический подход не обязательно сводится к выбору между «цифрой вместо плёнки» и хранением всего без разбора. Оцифрованный массив можно использовать как рабочий слой — для поиска, подготовки монтажа и предоставления доступа сотрудникам, — а оригиналы сохранять там, где этого требуют их состояние, ценность или правовой статус. Условия и срок хранения каждой категории материалов редакция определяет отдельно, а цифровые копии сопровождает сведениями о происхождении и проведённой обработке.
Оцифровка не отменяет ответственности за первоисточник. Она распределяет её между архивом, технологическим процессом и редактором.
Именно здесь проходит граница между техническим проектом и редакционной инициативой. MAM, OCR, распознавание речи и другие инструменты помогают сохранить материалы и сделать их доступнее, но не отвечают за то, как редакция будет обращаться с собственной историей через пять, десять или двадцать лет. Для этого нужны понятные правила: как описывать архив, как отмечать автоматическую разметку, кто проверяет спорные фрагменты и какие оригиналы нельзя уничтожать после оцифровки.
Каждая редакция будет отвечать на эти вопросы в соответствии со своим фондом и ресурсами. Но если архив рассматривают только как расходы на хранение, его ценность становится видна слишком поздно — когда нужную кассету уже невозможно воспроизвести, а подшивка рассыпается от прикосновения. Цифровая трансформация редакции начинается не с появления нового интерфейса, а с решения считать прошлые материалы частью нынешней работы: доступной для поиска, проверяемой и не оторванной от первоисточника.